


Bối Cảnh
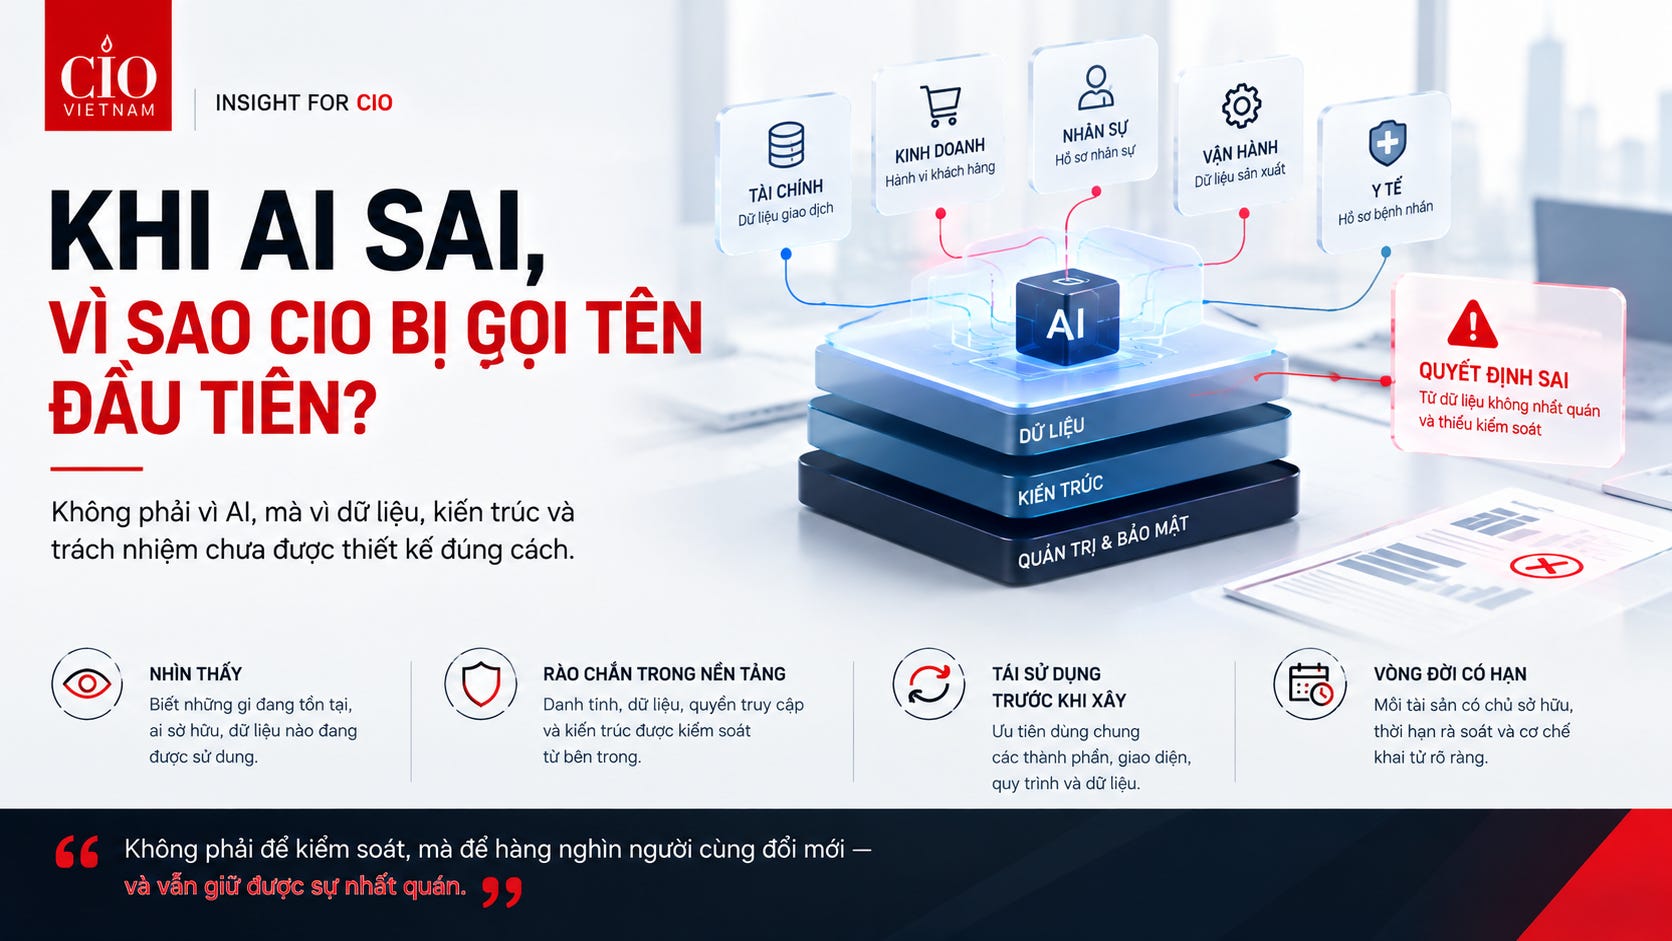
Một hệ thống AI ra quyết định sai — từ chối hàng loạt hồ sơ, gắn sai phân khúc khách hàng, xếp sai ưu tiên xử lý. Khi truy ngược, dữ liệu đầu vào đến từ ba, bốn phòng ban khác nhau, mỗi nơi khẳng định phần của mình đúng theo tiêu chuẩn riêng. Không ai sai theo đúng phạm vi việc được giao. Nhưng người phải giải trình với cấp trên thì luôn rõ ngay từ đầu: CIO.
Đây là cấu trúc vấn đề lặp lại dưới nhiều hình hài, ở nhiều ngành. Ba tình huống dưới đây là ví dụ tổng hợp, minh họa cho một mô hình vấn đề phổ biến trong quản trị dữ liệu AI.
Một tập đoàn sản xuất phát hiện dự báo nhu cầu lệch hướng suốt hai quý — hai nhà máy dùng hai quy ước ghi nhận tồn kho khác nhau, một nơi tính hàng đang vận chuyển là “đã nhập kho”, một nơi thì không. Hậu quả: hàng tồn kho thực tế lệch số liệu hệ thống đến mức phải điều chỉnh kế hoạch sản xuất khẩn cấp, kéo theo chi phí tồn kho phát sinh không nằm trong ngân sách.
Một chuỗi bán lẻ có hệ thống gợi ý cá nhân hóa gắn sai phân khúc cho hàng nghìn khách hàng, vì dữ liệu hành vi mua sắm cập nhật theo thời gian thực còn dữ liệu giao dịch chính thức chỉ cập nhật cuối ngày. Hậu quả: chiến dịch marketing nhắm sai đối tượng trong nhiều tuần trước khi bị phát hiện, ngân sách quảng cáo tiêu tốn cho nhóm khách hàng không đúng mục tiêu.
Một tổ chức y tế có hệ thống xếp ưu tiên lịch hẹn dựa trên dữ liệu từ nhiều khoa phòng có mức độ ghi chép khác hẳn nhau. Hậu quả: bệnh nhân ở khoa ghi hồ sơ sơ sài bị đẩy lùi thứ tự ưu tiên một cách hệ thống — không vì mức độ khẩn cấp thấp hơn, mà vì dữ liệu đầu vào mỏng hơn.
Ba ngành khác nhau, nhưng cùng một điểm chung: mỗi nguồn dữ liệu đúng theo định nghĩa và mục đích riêng của đơn vị tạo ra nó, nhưng trở nên không nhất quán khi được kết hợp để phục vụ một quyết định chung — đúng vào lúc hậu quả đã thành chi phí thật, không còn là rủi ro lý thuyết.
Insights
AI hiếm khi ăn dữ liệu từ một nguồn. Nó ăn từ nhiều phòng ban — mỗi nơi một tiêu chuẩn thu thập, một cách hiểu riêng về “dữ liệu đúng”. Có nhiều nguồn không phải là vấn đề; hệ thống nào cũng vậy. Vấn đề là: khi các nguồn hội tụ vào một quyết định, chỉ có người sở hữu từng đoạn, không có ai sở hữu toàn bộ chuỗi.
Quyền sở hữu dữ liệu, ở đa số tổ chức, không được thiết kế — nó rơi vào tay ai gần vận hành nhất, theo quán tính. Câu hỏi “ai sở hữu dữ liệu đầu vào xuyên suốt vòng đời của nó” hiếm khi được đặt ra ở giai đoạn thiết kế. Nó chỉ xuất hiện sau sự cố — và lúc đó, câu trả lời đã bị định hình sẵn bởi việc ai đang đứng gần hệ thống nhất, chứ không phải bởi ai nên chịu trách nhiệm.
Nhưng “trách nhiệm dồn về CIO” không có nghĩa CIO là người duy nhất chịu trách nhiệm — và đây là chỗ cần phân định rõ, thay vì để nguyên như một sự đã rồi. CIO chịu trách nhiệm cho nền tảng công nghệ vận hành hệ thống, cho việc các nguồn dữ liệu được tích hợp đúng kỹ thuật, và cho khả năng truy nguyên — khi có sự cố, hệ thống có cho phép lần ngược lại dữ liệu đã đi qua những đâu hay không. Đơn vị nghiệp vụ tạo ra dữ liệu chịu trách nhiệm cho ý nghĩa và chất lượng của dữ liệu đó — dữ liệu có phản ánh đúng thực tế kinh doanh, có được cập nhật đúng chu kỳ, có được định nghĩa nhất quán với các đơn vị khác hay không.
Ranh giới này, trên lý thuyết, không khó vẽ. Cái thiếu ở phần lớn tổ chức là một người chịu trách nhiệm cho toàn bộ chuỗi từ dữ liệu đến mô hình, đến quyết định, đến kết quả cuối cùng — không phải để thay thế CIO hay đơn vị nghiệp vụ, mà để đảm bảo hai trách nhiệm trên thực sự khớp với nhau ở từng điểm giao. Khi vai trò này bỏ ngỏ, CIO trở thành người mặc định gánh phần trách nhiệm chưa ai nhận — không phải vì đó là đúng vai trò của CIO, mà vì CIO là điểm hội tụ duy nhất còn lại khi không ai khác đứng ra.
Việc trách nhiệm tự động dồn về CIO, vì vậy, không phải là vấn đề của riêng CIO. Nó là dấu hiệu cho thấy tổ chức chưa thiết kế rõ quyền sở hữu dữ liệu, quyền quyết định, và trách nhiệm đầu-cuối đối với kết quả AI. Đây cũng chính là câu hỏi về quyền hạn — ai có quyền làm gì, ở đâu trong chuỗi — mà một tổ chức cần trả lời tách bạch khỏi câu hỏi về sở hữu dữ liệu, và là chủ đề sẽ được đào sâu hơn trong phần sau của loạt bài này.
Hành Động
Ngắn hạn — giải quyết ngay cho hệ thống AI quan trọng
Không cần một dự án quản trị dữ liệu quy mô lớn để bắt đầu. Cần ba việc cụ thể, cho một hệ thống — không phải toàn bộ danh mục AI của tổ chức.
Một, chọn hệ thống AI quan trọng nhất đang vận hành và vẽ sơ đồ đường đi dữ liệu của nó — từ nơi phát sinh đến điểm ra quyết định cuối cùng. Liệt kê rõ: dữ liệu đến từ phòng ban nào, ai tạo ra nó, ai xử lý và chuẩn hóa, ai đưa nó vào mô hình. Ở phần lớn tổ chức, sơ đồ này chưa từng tồn tại. Không cần hoàn hảo ngay. Cần có một bản để chỉ tay vào khi sự cố xảy ra, thay vì dựng lại nó từ đầu trong lúc khẩn cấp.
Hai, gán một người phụ trách dữ liệu ở tầng vận hành cho từng điểm nối giữa các nguồn — không chỉ cho từng nguồn riêng lẻ. Điểm nối là nơi dữ liệu tồn kho của nhà máy A gặp dữ liệu của nhà máy B, nơi dữ liệu hành vi thời gian thực gặp dữ liệu giao dịch cuối ngày. Việc của người này là hợp nhất: xác nhận hai nguồn khi ghép lại có còn phản ánh đúng một thực tế duy nhất hay không, trước khi dữ liệu vào mô hình — không phải kiểm tra tính toàn vẹn kỹ thuật, mà kiểm tra ý nghĩa nghiệp vụ. Nếu chưa ai được gán việc này, hãy gán ngay, kể cả tạm thời. Một cái tên cụ thể vẫn hơn một khoảng trống.
Ba, đặt một mốc thời gian chẩn đoán cho sự cố dữ liệu, và kiểm tra nó bằng một tình huống giả định ngay. Ví dụ: khi hệ thống ra quyết định sai do nghi ngờ ở dữ liệu đầu vào, tổ chức phải xác định được nguồn gốc lỗi trong vòng 4 giờ — không phải 4 giờ họp để từng phòng ban lần lượt khẳng định phần việc của mình không có vấn đề. Chọn con số phù hợp với tổ chức mình, rồi thử ngay bằng một tình huống giả định để biết con số thật đang là bao nhiêu.
Ba việc trên xử lý được sự cố tiếp theo. Chúng không xử lý được nguyên nhân khiến sự cố này lặp lại mỗi năm dưới một hình hài khác.
Dài hạn — đưa quyền sở hữu vào thiết kế, đo bằng ngôn ngữ tài chính
Gán người xử lý sự cố là phản ứng, không phải giải pháp. Quyền sở hữu dữ liệu cần trở thành một hạng mục trong thiết kế hệ thống AI ngay từ đầu — cùng cấp với bảo mật hay hiệu năng, không phải tài liệu bổ sung sau khi mô hình đã chạy. Mọi đề xuất xây hệ thống AI mới nên trả lời được ai sở hữu từng nguồn dữ liệu và ai sở hữu từng điểm nối, trước khi duyệt ngân sách — không phải trước khi đưa vào vận hành chính thức.
Nhưng quyền sở hữu nêu ra mà không đo được thì chỉ nằm trên giấy. Cần một KPI đi kèm, và KPI đó chỉ có sức nặng nếu Hội đồng quản trị đọc được bằng ngôn ngữ họ dùng hằng ngày: tiền. Thay vì báo cáo chất lượng dữ liệu bằng phần trăm trường dữ liệu đầy đủ hay số lỗi định dạng, hãy quy nó ra chi phí đã phát sinh hoặc rủi ro đang treo — số hồ sơ bị từ chối sai do dữ liệu lệch, số giờ nhân sự tiêu tốn để truy vết một sự cố, giá trị hợp đồng hoặc doanh thu bị ảnh hưởng bởi một quyết định sai.
Không phải mọi hậu quả đều quy đổi trực tiếp ra tiền ngay được — rủi ro tuân thủ, rủi ro công bằng đối với khách hàng, rủi ro danh tiếng thường khó lượng hóa hơn chi phí vận hành. Nhưng phần lớn trong số đó vẫn có thể ước tính bằng ngôn ngữ tài chính khi cần: rủi ro tuân thủ quy thành mức phạt tiềm năng, rủi ro danh tiếng quy thành chi phí xử lý khủng hoảng truyền thông ước tính. Giữ nguyên tắc này — mọi tác động, kể cả phi tài chính, đều cố gắng có một con số đi kèm — để một dòng trong P&L luôn thuyết phục hơn một chỉ số kỹ thuật chỉ đội công nghệ đọc.
Khi quyền sở hữu nằm trong thiết kế và chất lượng dữ liệu được đo bằng tiền, câu hỏi “ai chịu trách nhiệm khi AI sai” không còn cần một cuộc họp hai giờ để trả lời. Nó đã có sẵn câu trả lời từ trước khi hệ thống được duyệt chạy.
Tác giả: Trần Thị Bảo Thùy | AINEXT Advisory
